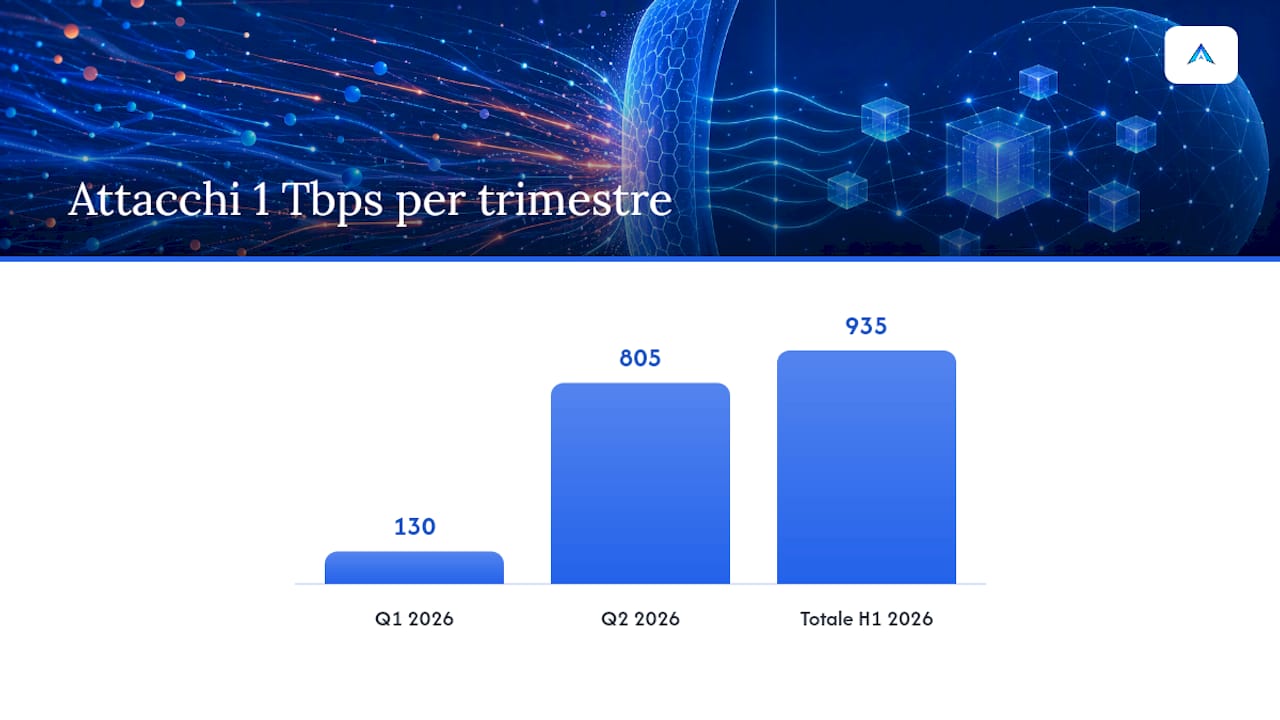
Gli attacchi DDoS superiori a 1 Tbps non sono più eventi eccezionali: Cloudflare ne ha mitigati 935 nel primo semestre 2026, con un salto da 130 a 805 episodi tra Q1 e Q2. La conseguenza operativa è netta: chi gestisce infrastrutture esposte deve passare da mitigazioni manuali a sistemi automatici e always-on, con capacità di scrubbing distribuita pronta a intervenire in pochi secondi. I dettagli su vettori, impatti e contromisure arrivano nelle prossime sezioni.
In breve:
- Per contrastarli efficacemente serve combinare scrubbing distribuito always-on, regole Flowspec pre-testate e mitigazione in-network automatica in millisecondi.
- La capacità di rete deve essere dimensionata sul peggio, e non sulla media annua, poiché un attacco di 1 Tbps può bloccare la rete in pochi secondi.
- La maggior parte degli attacchi si distribuisce su blocchi di indirizzi e colpisce DNS autoritativi, saturando le connessioni e trasformando il problema in una questione di instradamento.
- Gli strumenti di protezione DDoS integrati nell’infrastruttura, come quelli di AtomSync, eliminano la necessità di competenze avanzate e hardware dedicato per i piccoli team.
Indice
- Trend e numeri chiave degli attacchi DDoS 1 Tbps in H1 2026
- Vettori dominanti: DNS flood, amplification e CLDAP
- Chi viene colpito e cosa succede davvero durante l’attacco
- Architetture di mitigazione: scrubbing, Flowspec, RTBH e risposta in-network
- KPI, playbook e governance per attacchi ipervolumetrici
- Cosa offre AtomSync sul fronte protezione DDoS e risorse tecniche
- Perché il record di Tbps è la metrica sbagliata su cui concentrarsi
- Attivare protezione DDoS senza gestire l’infrastruttura da solo
- Fonti
- Domande frequenti
Trend e numeri chiave degli attacchi DDoS 1 Tbps in H1 2026
Cloudflare ha registrato 935 attacchi DDoS oltre 1 Tbps nell’intero semestre, ma la distribuzione temporale racconta la vera storia: 130 episodi in Q1, 805 in Q2.
Il paradosso è che la maggior parte degli attacchi resta piccola. Circa il 96,6% delle mitigazioni ha riguardato traffico sotto i 500 Mbps, e il 90,6% degli episodi è durato meno di dieci minuti. Questo significa che i pochi eventi da 1 Tbps convivono con un rumore di fondo costante fatto di attacchi brevi e minori, e i sistemi di difesa devono gestire entrambi i registri senza differenziare la risposta in base alla scala percepita.
Tre implicazioni pratiche per chi progetta un piano di risposta:
- Un attacco può raggiungere il picco di ampiezza in pochi secondi, quindi qualsiasi mitigazione che dipenda da un’escalation umana arriva sistematicamente in ritardo.
- La cadenza degli episodi richiede rilevamento automatico e soglie dinamiche, non regole statiche configurate una volta all’anno.
- La capacità di rete deve essere dimensionata sul picco peggiore, non sulla media storica del traffico malevolo.
Un consiglio: non giudicare la maturità della propria defesa dal numero di attacchi bloccati nell’ultimo trimestre. Un solo evento da 1 Tbps non gestito in tempo può costare più di cento attacchi minori respinti senza sforzo.
Vettori dominanti: DNS flood, amplification e CLDAP
I DNS flood sono diventati il vettore più usato per costruire attacchi ipervolumetrici. Nel secondo trimestre 2026 il traffico legato al DNS è passato dal 25,7% al 40% del totale rilevato da Cloudflare, superando in pochi mesi altre tecniche più tradizionali. Il meccanismo è semplice da capire e complesso da fermare: un aggressore invia richieste con IP di origine falsificato a resolver DNS aperti, che rispondono al bersaglio reale amplificando il volume originale di decine di volte.
Il protocollo CLDAP segue una logica simile ma con un fattore di amplificazione ancora più aggressivo, perché le risposte dei server LDAP configurati in modo permissivo possono superare di molto la dimensione della richiesta iniziale. Combinare più vettori di reflection nella stessa campagna è oggi la normalità, non l’eccezione, e questo spiega perché i picchi da 1 Tbps si raggiungono con relativa facilità anche partendo da botnet di dimensioni modeste.
Le contromisure a livello di servizio restano concrete e alla portata di chi gestisce reti medio grandi:
- Chiudere o limitare l’accesso pubblico ai resolver DNS aperti sotto il proprio controllo.
- Applicare rate limiting per protocollo su DNS, LDAP e NTP prima che il traffico raggiunga i sistemi applicativi.
- Filtrare a livello di edge il traffico con firma di amplification, riconoscibile dalla dimensione anomala della risposta rispetto alla richiesta.
Chi viene colpito e cosa succede davvero durante l’attacco
Media, pubblica amministrazione e servizi ad alta visibilità restano i bersagli più frequenti, spesso per motivazioni opportunistiche più che geopolitiche. Un attacco da 1 Tbps non colpisce quasi mai un singolo IP: la tecnica del carpet bombing distribuisce il traffico su interi blocchi di indirizzi, rendendo inefficace qualsiasi defesa impostata sul singolo host. La risposta corretta a questo pattern richiede scrubbing a livello di prefisso con capacità ridondante distribuita su più punti della rete.
Gli effetti pratici si vedono prima sui DNS autoritativi, che collassano sotto il carico prima ancora che l’applicazione principale registri un calo di prestazioni. Poi arriva la saturazione della connettività upstream, che trasforma un problema applicativo in un problema di instradamento su scala regionale. Un aspetto spesso sottovalutato: il takedown delle botnet riduce il rumore di fondo ma non elimina la capacità d’attacco disponibile sul mercato, perché le infrastrutture di reflection sfruttate restano spesso legittime e riutilizzabili in campagne successive.
Architetture di mitigazione: scrubbing, Flowspec, RTBH e risposta in-network
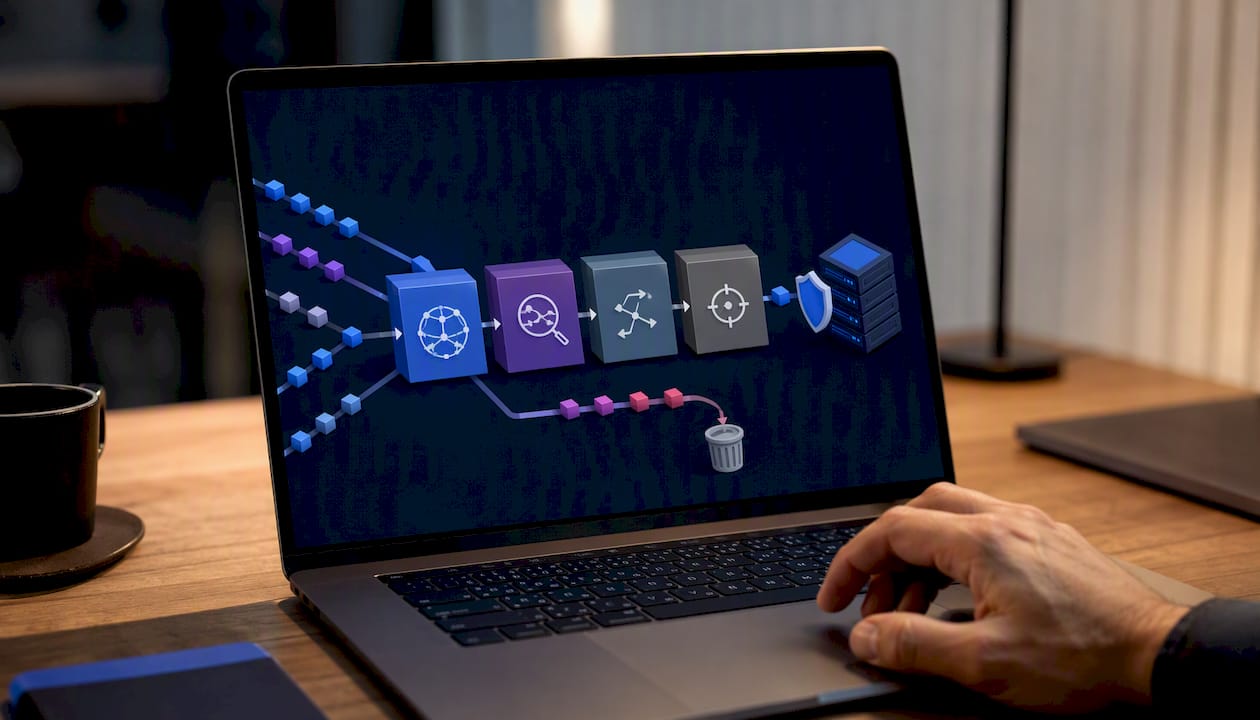
Nessuna singola tecnica basta da sola contro un attacco da 1 Tbps. La combinazione di scrubbing multirebus, threat intelligence e BGP Flowspec è oggi lo standard operativo per chi difende infrastrutture di rete esposte, e ognuna di queste tecniche risponde a un problema diverso.
Lo scrubbing distribuito funziona deviando il traffico sospetto verso centri di pulizia dedicati, tipicamente organizzati con anycast e cross-connect verso più transit provider. Questa architettura garantisce margine di capacità: se un singolo nodo di scrubbing satura, il traffico si ridistribuisce automaticamente su altri punti della rete senza intervento manuale. È il requisito minimo per assorbire un picco improvviso da centinaia di Gbps senza che l’attacco raggiunga la rete di destinazione.
BGP Flowspec e RTBH (Remotely Triggered Black Hole) risolvono due esigenze opposte:
- Flowspec permette regole chirurgiche, ad esempio bloccare solo il traffico UDP su una porta specifica proveniente da certi prefissi, lasciando intatto il resto del servizio. Il compromesso è la complessità: regole Flowspec non validate con i transit provider possono impattare traffico legittimo, quindi servono test e playbook di rollback pronti prima dell’emergenza, non durante.
- RTBH annulla completamente il traffico verso un IP o prefisso bersaglio. È rapido da attivare ma drastico: la risorsa colpita diventa irraggiungibile anche per gli utenti legittimi, un compromesso accettabile solo quando l’alternativa è il collasso di tutta la rete a monte.
La mitigazione in-network aggiunge un terzo livello, quello della velocità pura. Sistemi di telemetria come sFlow abbinati a motori di analisi come FastNetMon possono installare regole Flowspec o RTBH direttamente nell’ASIC dei router in una manciata di secondi, senza passare per un intervento umano nella catena decisionale.
| Tecnica | Tempo di attivazione | Precisione | Rischio principale |
|---|---|---|---|
| Scrubbing distribuito | Secondi (automatico) | Alta, filtra per pattern | Costo di capacità upstream |
| BGP Flowspec | Secondi con regole pre-testate | Molto alta, chirurgica | Regole non validate bloccano traffico legittimo |
| RTBH | Quasi immediato | Nulla, blocca tutto il prefisso | Interruzione totale del servizio colpito |
| Mitigazione in-network (ASIC) | Millisecondi | Alta se telemetria accurata | Richiede hardware e configurazione dedicati |
I requisiti pratici per rendere questa architettura affidabile includono ridondanza geografica dei punti di scrubbing, accordi contrattuali chiari con i transit provider sui volumi garantiti, e test di failover pianificati con regolarità, non solo dopo un incidente reale.
KPI, playbook e governance per attacchi ipervolumetrici
La combinazione di volumi estremi e velocità di esecuzione rende obsoleti i modelli di risposta che dipendono dall’intervento umano: con il 90,6% degli attacchi che dura meno di dieci minuti, ogni minuto passato ad attendere l’escalation di un operatore è tempo di downtime che nessun SLA può recuperare.
Tre metriche dovrebbero guidare qualsiasi revisione della postura di sicurezza:
- Time-to-detect: quanto tempo passa tra l’inizio dell’anomalia di traffico e il suo riconoscimento come attacco.
- Time-to-mitigate: quanto tempo intercorre tra il rilevamento e l’attivazione effettiva della contromisura.
- Percentuale di mitigazioni automatiche: quota di eventi risolti senza intervento manuale, obiettivo che dovrebbe tendere al massimo possibile per gli attacchi sotto una certa soglia di complessità.
Una checklist operativa minima per i team di rete e SOC comprende test periodici di failover tra i nodi di scrubbing, la verifica contrattuale degli SLA di mitigazione con i provider upstream, ed esercitazioni tabletop che simulino uno scenario di carpet bombing su più prefissi contemporaneamente. La threat intelligence geopolitica aiuta a prevedere campagne coordinate: per eventi ad alta visibilità, come lanci di prodotto o periodi elettorali, alzare temporaneamente le soglie di allerta riduce il rischio di sorprese.
Un consiglio: quando valutate un fornitore di protezione DDoS, chiedete sempre tre numeri concreti: capacità totale di scrubbing in Tbps, numero e localizzazione dei punti di presenza, e SLA scritto sul tempo massimo di mitigazione. Se non riescono a rispondere con cifre precise, non hanno l’infrastruttura che dichiarano.
Cosa offre AtomSync sul fronte protezione DDoS e risorse tecniche
Chi gestisce server di gioco affronta lo stesso problema su scala diversa: un attacco anche modesto può bastare a rendere ingiocabile un server Minecraft o Rust durante un evento community. AtomSync integra protezione DDoS fino a 1 Tbps direttamente nell’infrastruttura di hosting, con provisioning dei server in meno di 60 secondi e un pannello Pterodactyl personalizzato che semplifica la gestione anche per chi non ha background di networking.
Alcuni punti tecnici utili per chi vuole approfondire prima di scegliere un piano:
- La guida tecnica sulla protezione DDoS per server gaming spiega configurazioni pratiche e casi d’uso reali per titoli come Rust, Palworld e Valheim.
- Il supporto tecnico via Discord in italiano copre troubleshooting e configurazioni, riducendo il tempo di risoluzione durante un incidente.
- La documentazione su hosting e infrastruttura in Italia descrive come storage NVMe e backup automatici si integrano con la protezione di rete.
Perché il record di Tbps è la metrica sbagliata su cui concentrarsi
Il numero da 1 Tbps fa notizia, ma è la metrica meno utile per chi deve allocare un budget di sicurezza. Quello che conta davvero è quanto velocemente un sistema rileva l’anomalia e attiva la contromisura, non quanto grande fosse l’attacco che avreste potuto subire in teoria.
Allocherei il budget in questo ordine: prima capacità di scrubbing sempre attiva, poi automazione della detection, solo alla fine intelligence predittiva su campagne future. Un sistema lento che assorbe 2 Tbps è meno utile di uno rapido che ne assorbe 800 Gbps in tre secondi. Chi ha già scrubbing e Flowspec separati dovrebbe testarne l’integrazione in un’esercitazione reale, non aspettare il prossimo incidente per scoprire che le due tecnologie non si parlano.
— Fabio Turi
Attivare protezione DDoS senza gestire l’infrastruttura da solo
Costruire in autonomia scrubbing distribuito, regole Flowspec testate e telemetria in-network richiede competenze di rete che la maggior parte delle community gaming e dei piccoli team semplicemente non ha, oltre a un investimento hardware che raramente si giustifica per un singolo server. AtomSync include protezione DDoS avanzata già configurata in ogni server attivato, senza bisogno di negoziare accordi con transit provider o validare regole di mitigazione manualmente.
Guarda i piani disponibili per Minecraft, Rust, Palworld e gli altri titoli supportati e scegli la configurazione più adatta alla tua community: puoi cambiare risorse in qualsiasi momento senza dover ricreare il server da zero.
Fonti
Cloudflare DDoS Threat Report H1 2026, documentazione ACN e analisi tecniche su Flowspec/RTBH restano i riferimenti primari citati in questo articolo.
- Cloudflare DDoS Threat Report H1 2026
- DDoS attacks hit record scale as 1 Tbps+ campaigns become more common - Help Net Security
Domande frequenti
Qual è il metodo più efficace per contrastare un attacco DDoS?
Non esiste un singolo metodo definitivo: la combinazione di scrubbing distribuito always-on, regole BGP Flowspec pre-testate e mitigazione automatica in-network offre la risposta più rapida ed efficace contro attacchi superiori a 1 Tbps.
Cosa succede in un attacco DDoS?
Un aggressore invia traffico massivo, spesso tramite reflection su DNS o CLDAP, verso un bersaglio fino a saturarne la connettività o i server DNS autoritativi. La maggior parte degli attacchi rilevati da Cloudflare dura meno di dieci minuti, quindi la finestra di risposta utile è breve.
Che cos’è la protezione DDoS anti guardia?
Un servizio di protezione DDoS (anti guard) filtra il traffico malevolo prima che raggiunga l’infrastruttura del cliente, tipicamente tramite scrubbing distribuito e regole di rete automatizzate. AtomSync integra questa protezione fino a 1 Tbps direttamente nei propri piani di hosting per server di gioco.
Perché gli attacchi da 1 Tbps sono aumentati così tanto in H1 2026?
Cloudflare attribuisce la crescita soprattutto alla diffusione di vettori di reflection e amplification, in particolare DNS flood e CLDAP, che permettono di generare volumi enormi partendo da botnet relativamente piccole.
Quanto tempo serve per mitigare un attacco DDoS ipervolumetrico?
Con sistemi automatici e mitigazione in-network basata su telemetria come sFlow, l’attivazione delle regole di defesa può avvenire in pochi secondi o millisecondi, molto più rapidamente di qualsiasi processo che dipenda da un intervento umano.